Ad agosto 2026 convergono tre sviluppi che raccontano con particolare chiarezza il passaggio dell’AI generativa dalla sperimentazione alla gestione strutturata all’interno delle aziende. Il regolatore europeo comincia infatti a rendere effettive le norme introdotte due anni fa e i principali fornitori di modelli competono sui prezzi, modificando l’equilibrio economico delle soluzioni basate sull’intelligenza artificiale. Intanto, la ricerca scientifica assistita dall’intelligenza artificiale inizia a produrre risultati verificabili, andando oltre la dimensione delle demo.
Presi singolarmente, questi sono segnali già rilevanti, ma osservati insieme, indicano proprio un cambio di fase: per le imprese, la domanda non è più soltanto che cosa si possa fare con l’AI generativa, ma come governarla, integrarla e misurarne il valore.
1. Dal 2 agosto, l’AI Act diventa operativo
Il 2 agosto 2026 segna un passaggio decisivo per l’applicazione dell’AI Act europeo, il Regolamento UE 2024/1689.
Da questa data diventano applicabili due elementi centrali:
- il primo riguarda gli obblighi di trasparenza dell’art. 50. I sistemi che interagiscono direttamente con le persone, come i chatbot, devono informare gli utenti che stanno dialogando con un’AI, salvo quando ciò risulti già evidente. I fornitori di sistemi che generano contenuti sintetici devono inoltre fare in modo che gli output siano identificabili in un formato leggibile dalle macchine. Per chi utilizza questi sistemi, l’obbligo di disclosure visibile riguarda in particolare i deepfake e i testi generati o manipolati dall’AI pubblicati per informare il pubblico su temi di interesse generale, con le eccezioni previste dal Regolamento;
- il secondo riguarda i poteri di enforcement della Commissione europea sui modelli di intelligenza artificiale per finalità generali, i cosiddetti GPAI. Gli obblighi per i fornitori di questi modelli sono applicabili dal 2 agosto 2025 e sempre dalla stessa data la Commissione può farli rispettare ed eventualmente sanzionarne la violazione. Per le violazioni degli obblighi relativi ai modelli di AI per finalità generali (GPAI), le sanzioni possono arrivare fino a 15 milioni di euro o al 3% del fatturato mondiale annuo totale dell’esercizio precedente, a seconda di quale importo sia più elevato.
È un cambio di natura, non solo di scadenza: fino ad oggi l’AI Act era un insieme di obblighi senza conseguenze immediate; da questa data diventa una norma che si può violare concretamente, con multe reali.
Nel frattempo, il Digital Omnibus, approvato dal Consiglio UE il 29 giugno 2026, ha posticipato al 2026-2028 alcune scadenze più onerose (i requisiti sui sistemi ad alto rischio, in parte l’obbligo di marcatura tecnica dei contenuti sintetici), ma la trasparenza di base e l’enforcement restano confermati per agosto.
Perché conta per un’azienda
Chiunque produca o distribuisca contenuti generati con AI – descrizioni prodotto, immagini, chatbot di assistenza, video – dovrebbe verificare entro fine mese se i propri strumenti (e quelli dei fornitori terzi che usa) rispettano già questi obblighi di etichettatura e disclosure. Non è più solo un tema legale astratto: da agosto ha un costo quantificabile in caso di inadempienza.
2. La guerra dei prezzi tra i modelli frontier
Tra la fine di giugno e la prima metà di luglio 2026, il mercato ha registrato una sequenza particolarmente intensa di nuovi lanci.
- Anthropic ha presentato Claude Sonnet 5 il 30 giugno, proponendo fino al 31 agosto un prezzo introduttivo di 2 dollari per milione di token in input e 10 dollari per milione di token in output. In seguito, le tariffe dovrebbero salire rispettivamente a 3 e 15 dollari. Il modello punta a offrire prestazioni vicine a quelle di Opus 4.8 a un costo sensibilmente inferiore.
- xAI/SpaceXAI ha reso Grok 4.5 disponibile tramite API, al prezzo di 2 dollari per milione di token in input e 6 dollari per l’output; l’annuncio pubblico del modello è seguito il 16 luglio. L’azienda dichiara inoltre una maggiore efficienza nell’uso dei token rispetto ad altri modelli di fascia alta. Contrariamente ad alcune ricostruzioni circolate online, dal 17 luglio la documentazione ufficiale segnala la disponibilità di Grok 4.5 anche nella console API per gli utenti dell’Unione europea.
- IOpenAI ha rilasciato la famiglia GPT-5.6 – Sol, Terra e Luna – articolata su tre livelli di capacità e costo. Il 30 luglio l’azienda ha poi ridotto del 20% il prezzo di Terra e dell’80% quello di Luna: secondo la documentazione API aggiornata, Terra costa 2 dollari per milione di token in input e 12 dollari per l’output, mentre Luna scende a 0,20 dollari in input e 1,20 dollari in output. Sol resta posizionato a 5 dollari in input e 30 dollari in output.
- Meta ha aperto per la prima volta un’API self-serve per un proprio modello frontier a prezzi contenuti.
Il risultato è un mercato in cui confrontare il solo costo per token non basta più, la metrica più utile sta diventando il costo per task completato: quanto costa, in termini reali, affidare a un modello un’attività agentica e portarla a termine con il livello di qualità richiesto? Il prezzo unitario, infatti, deve essere letto insieme al numero di token generati, ai passaggi necessari, alla velocità e al tasso di successo del modello. Le differenze possono essere significative, ma vanno misurate sui processi reali dell’azienda anziché dedotte dal listino.
Perché conta per un’azienda
Per le imprese che hanno già integrato l’AI generativa nei propri processi, questo è il momento di riconsiderare il mix di modelli utilizzati. Il modello più potente o quello con il prezzo nominale più basso non coincide necessariamente con la scelta più conveniente.
La valutazione deve comprendere prestazioni, affidabilità, velocità, costo complessivo del task e possibilità di utilizzo nel mercato di riferimento. In Europa, soprattutto, disponibilità geografica e conformità normativa diventano parte integrante dell’architettura tecnologica e delle scelte di fornitura.
3. Dalla previsione alla verifica: l’intelligenza artificiale applicata alla scienza
Il terzo sviluppo è meno legato alla cronaca quotidiana, ma può avere conseguenze ancora più profonde nel medio periodo.
Durante I/O 2026, Google ha presentato Gemini for Science, una suite sperimentale di strumenti progettata per supportare la ricerca nella formulazione di ipotesi e nella sperimentazione computazionale. La sua base tecnologica comprende ERA, Empirical Research Assistance, e Co-Scientist, entrambi descritti in lavori sottoposti a revisione paritaria e pubblicati su *Nature* nel maggio 2026. L’accesso agli strumenti viene aperto progressivamente attraverso collaborazioni con la comunità scientifica.
Questa evoluzione si innesta su risultati precedenti. Nel 2023 GNoME, il sistema di Google DeepMind per la scoperta di materiali, ha identificato 2,2 milioni di nuove strutture cristalline considerate stabili e ne ha messe 381.000 a disposizione del Materials Project. Nello stesso anno A-Lab, il laboratorio autonomo sviluppato al Lawrence Berkeley National Laboratory e all’Università della California, Berkeley, ha sintetizzato con successo 41 nuovi composti su 58 tentativi in 17 giorni di attività. Sono risultati distinti, ma complementari: mostrano come previsione computazionale, pianificazione degli esperimenti, sintesi e verifica possano entrare in un ciclo sempre più integrato.
È proprio la chiusura di questo ciclo — previsione, sintesi, verifica — a rappresentare il passaggio più significativo. L’intervento umano resta centrale, ma l’AI può contribuire ad accelerare attività che tradizionalmente richiedono tempi molto più lunghi e un elevato numero di tentativi.
Non siamo ancora davanti a scienziati artificiali completamente autonomi. Siamo però di fronte a strumenti capaci di incidere sul ritmo della ricerca applicata e di ampliare lo spazio delle ipotesi esplorabili.
Perché conta per un’azienda
L’impatto è evidente per chi opera nei materiali, nella chimica, nella farmaceutica e nei settori ad alta intensità di ricerca. Il segnale riguarda però anche tutte le organizzazioni che considerano l’intelligenza artificiale una leva per innovare prodotti, servizi e processi.
Finora gran parte dell’attenzione si è concentrata sull’aumento della produttività. La nuova frontiera riguarda la capacità di ridurre i tempi della scoperta, valutare più alternative e portare più rapidamente un’intuizione verso una verifica concreta.
Dalla sperimentazione alla governance
Agosto 2026 segna quindi un cambio di passo su tre livelli: normativo, economico e scientifico.
Per le aziende, il primo passo è verificare la conformità degli strumenti e dei contenuti generati con l’AI rispetto agli obblighi di trasparenza in vigore dal 2 agosto. Il secondo è riesaminare i modelli utilizzati, confrontando il costo effettivo delle attività svolte e considerando i vincoli di disponibilità e conformità. Il terzo è ampliare lo sguardo oltre l’efficienza operativa, osservando le applicazioni dell’AI nella ricerca e nello sviluppo di nuovi prodotti.
L’intelligenza artificiale generativa non è più soltanto una tecnologia da testare, è un’infrastruttura da governare, una voce di costo da ottimizzare e, sempre più spesso, uno strumento con cui costruire innovazione verificabile.
La Cina valuta di chiudere i suoi modelli AI di frontiera. Perché è importante e rischia di cambiare molte cose.
Editoriale di Francesco Ronchi
Per due anni ci siamo raccontati una storia semplice: l’open source vince sempre, i modelli aperti renderanno l’AI una commodity, i lab proprietari americani sono destinati a essere erosi dal basso. La Cina era il campione mondiale di questa narrativa. Oggi quella storia va riscritta, perché è proprio Pechino a valutare di sigillare la punta della sua piramide tecnologica.
Cosa sta succedendo
Secondo un’esclusiva Reuters del 7 luglio, le autorità cinesi hanno tenuto nell’ultimo mese una serie di incontri con le principali aziende tech del paese per discutere la possibilità di limitare l’accesso estero ai modelli AI cinesi più avanzati, inclusi quelli non ancora rilasciati. Ai tavoli erano presenti Alibaba, ByteDance e la startup Z.ai, quella del modello GLM-5.2 che ha fatto rumore nella Silicon Valley per prestazioni vicine ai migliori modelli americani a una frazione del costo.
Un dettaglio che vale più di molte analisi: gli incontri sono guidati dal Ministero del Commercio, l’ente che gestisce l’export control, con la partecipazione della NDRC, l’agenzia di pianificazione statale. Non è il regolatore di internet che parla di censura dei contenuti. È la macchina dell’export e della pianificazione economica che tratta i modelli AI come asset strategici nazionali, esattamente come i semiconduttori o le terre rare.
Sul tavolo ci sono tre misure:
- Limiti all’accesso estero ai modelli più avanzati, sia closed-source sia open-weight. E l’inclusione degli open-weight è il punto esplosivo.
- Rendere qualsiasi leak o furto di tecnologia AI proprietaria un reato sotto la legge di sicurezza nazionale cinese, tra le più severe al mondo.
- Nuove restrizioni su chi può finanziare le startup AI domestiche, quindi un filtro sul capitale estero.
Precisazione doverosa: nulla è deciso, per ora. Lo scope è in discussione, le restrizioni potrebbero applicarsi solo ai modelli futuri e non c’è una timeline. I ministeri coinvolti non hanno commentato. Ma il fatto stesso che la conversazione esista è la notizia.
Come potrebbe funzionare: la piramide a tre livelli
Reuters cita un indizio concreto su come Pechino sta ragionando. A maggio una tavola rotonda di giuristi cinesi, i cui atti sono stati pubblicati su una rivista ufficiale della Corte Suprema del Popolo, ha proposto un sistema a livelli: gli strumenti open source di base soggetti a una semplice registrazione, le tecnologie più avanzate sottoposte a security review, e i modelli di frontiera più sensibili vietati al rilascio pubblico o limitati all’uso domestico.
Non un blocco totale dell’open source cinese, quindi, ma una piramide dove solo la punta viene sigillata. Qwen, DeepSeek e gli altri modelli già pubblicati continueranno a esistere, per una ragione tecnica prima che politica: una volta che i pesi di un modello sono online, sono irrecuperabili. Non si possono richiamare, non si possono aggiungere safeguard a posteriori. Qualsiasi restrizione futura vale solo per ciò che non è ancora uscito.
Perché è un U-turn clamoroso
Qui sta il cuore della storia. La strategia open-weight cinese non era generosità: era la leva competitiva di un inseguitore. I modelli cinesi sono in ritardo di circa sette mesi sui migliori americani nei benchmark chiave, ma sono gratuiti e scaricabili. Questa combinazione ha permesso loro di penetrare i mercati globali, incluse aziende americane che li hanno adottati per tagliare i costi rispetto ai modelli proprietari USA. “Commodificare” l’AI americana, erodere il business model dei lab di frontiera, costruire soft power tecnologico verso il Global South: la strategia funzionava.
Un inseguitore non abbandona il suo vantaggio più grande a meno che la posta in gioco non sia la sicurezza nazionale. E infatti il trigger è identificabile con precisione: a fine giugno Z.ai ha rilasciato GLM-5.2 dichiarando di aver eguagliato le capacità di individuare vulnerabilità software di Claude Mythos, il modello di Anthropic riservato ai professionisti della cybersecurity. Quando costruisci qualcosa che tu stesso consideri dual-use, l’idea di caricarlo gratis su Hugging Face per chiunque, inclusi i tuoi avversari geopolitici, improvvisamente non sembra più geniale.
L’apertura era una tattica, non un principio assoluto. Quando ti avvicini alla frontiera, smetti di ragionare come chi insegue e inizi a ragionare come chi difende.
La simmetria con Washington
Il paradosso è che Pechino sta copiando il copione americano riga per riga. A giugno l’amministrazione Trump ha ordinato che i cittadini stranieri non avessero accesso ai modelli più avanzati di Anthropic, Fable e Mythos, spingendo l’azienda a disabilitarli globalmente perché la nazionalità non era verificabile in tempo reale. I controlli su Fable, destinato al pubblico generale, sono poi stati rimossi dopo l’introduzione di nuove safeguard. Mythos resta accessibile solo ad alcune organizzazioni americane considerate affidabili.
E la paura cinese è speculare: secondo le fonti Reuters, le autorità di Pechino temono che Mythos possa sfruttare vulnerabilità software e che Washington possa usarlo contro interessi cinesi. Zhou Hongyi, fondatore del colosso della cybersecurity 360, ha detto pubblicamente che la Cina deve sviluppare il proprio Mythos. Come nota Scott Singer del Carnegie Endowment, la Cina dovrà fare i conti con la realtà che i modelli oltre certe capacità sono intrinsecamente insicuri, e sta per avere le stesse conversazioni che la Casa Bianca ha avuto negli ultimi mesi.
Due superpotenze, stesse ragioni, stessi strumenti (export control), stessi tipi di capacità sotto controllo (cyber-offensive).
L’AI di frontiera sta convergendo verso il regime del nucleare e della crittografia degli anni Novanta: tecnologia a duplice uso, controllata dallo stato.
La sottotrama: la guerra della distillazione
C’è un filone parallelo che rende il quadro ancora più teso, e riguarda Anthropic e Alibaba.
A febbraio Anthropic ha pubblicato un report sostenendo che DeepSeek, Moonshot e MiniMax avevano generato 16 milioni di scambi con Claude attraverso circa 24.000 account fraudolenti, con l’obiettivo di distillare le sue capacità, cioè usare gli output di un modello più forte per addestrare un modello più debole. A giugno l’accusa si è fatta pesante: in una lettera ai vertici della commissione bancaria del Senato USA, Anthropic ha accusato operatori affiliati al lab Qwen di Alibaba di aver usato questi account fraudolenti per generare 28,8 milioni di scambi con Claude in circa sei settimane, definendolo il più grande attacco di distillazione mai rilevato. Alibaba ha negato ogni illecito.
Poi la scoperta che ha fatto esplodere tutto: un developer ha rivelato via reverse engineering che Claude Code, dalla versione di aprile, conteneva un meccanismo nascosto che leggeva fuso orario, proxy e indirizzi API alla ricerca di keyword legate ad Alibaba, ByteDance e Baidu, per identificare silenziosamente utenti cinesi. Anthropic ha confermato l’esistenza del meccanismo, spiegandolo come esperimento anti-distillazione introdotto a marzo e poi rimosso.
La risposta di Alibaba è arrivata immediata: da domani, 10 luglio, i dipendenti hanno il divieto totale di usare Claude Code, classificato come software ad alto rischio, e l’ordine di disinstallare tutti i prodotti Anthropic, passando alla piattaforma interna Qoder. Nel frattempo Anthropic ha condotto un’ondata di ban di account cinesi, ed è emerso un mercato grigio che rivende accesso alle API di Claude a prezzi stracciati usando credenziali rubate, raccogliendo prompt e output da rivendere come dati di training. OpenAI, Anthropic e Google hanno lanciato una campagna anti-distillazione coordinata attraverso il Frontier Model Forum.
La distillazione è il collante delle due storie. Gli americani accusano i cinesi di rubare capacità via API. I cinesi ora temono che i loro pesi pubblicati vengano usati contro di loro. Entrambi arrivano alla stessa conclusione: chiudere.
Il quadro completo: il contenimento cinese va avanti da mesi
Il tavolo sull’export dei modelli non è un episodio isolato. Ad aprile il pianificatore statale cinese ha ordinato a Meta di annullare l’acquisizione da 2 miliardi di dollari della startup AI di fondazione cinese Manus. A inizio giugno sono arrivate nuove regole che stringono il controllo sulle operazioni estere che coinvolgono investitori, tecnologia e dati cinesi. Sono in corso indagini su Manus e altre startup AI trasferitesi all’estero per possibili violazioni delle leggi di export control. Il messaggio è coerente: l’AI cinese resta in Cina, il capitale che la finanzia viene filtrato, il talento che scappa viene indagato.
Cosa significa per le aziende italiane
Qui arrivo al punto che mi interessa di più, perché tocca direttamente molte aziende e startup italiane ed europee.
Molte aziende hanno costruito, o stanno valutando di costruire, stack AI su modelli cinesi open-weight. Il messaggio pratico è duplice:
- Primo: i modelli già rilasciati non spariscono. I pesi sono fuori e non rientrano. Chi usa oggi Deepseek, Qwen 3 o GLM in self-hosting può continuare a farlo.
- Secondo, e più importante: il flusso futuro di modelli di frontiera gratuiti dalla Cina non è più garantito. Chi ha fatto della disponibilità perpetua di open-weight cinesi di punta un’assunzione strategica deve rivederla. Se la vostra roadmap AI dipende dal fatto che tra sei mesi arriverà un modello cinese gratuito migliore di quello attuale, avete un rischio di supply chain che prima non esisteva.
Operativamente: le architetture model-agnostic diventano ancora più importanti. Progettare sistemi in cui il modello sottostante è un componente sostituibile è l’unica risposta razionale a un mondo in cui l’accesso ai modelli è diventato una variabile geopolitica.
Resta però una riflessione più ampia sulla sovranità tecnologica europea, e una domanda:
Se Stati Uniti e Cina chiudono entrambi la frontiera, l’Europa cosa può fare? Resta cliente di due sistemi chiusi, con Mistral come unica carta realmente autonoma? E’ sempre più urgente la creazione di un modello AI di frontiera “made in Europe”, libero e indipendente.
Il dibattito su AI Act e sovranità digitale, che spesso liquidiamo come burocrazia, assume un peso diverso quando le due superpotenze trattano i modelli come armi.
Il paradosso finale
Chiudo con l’ironia amara di questa vicenda. Le restrizioni cinesi, se arriveranno, varranno solo per il futuro. GLM-5.2, il modello che i cinesi stessi paragonano a Mythos per capacità di trovare vulnerabilità, è già scaricabile da chiunque, ovunque, per sempre. La stalla si chiude dopo che i buoi migliori sono già usciti.
C’è un argomento serio, che vale per entrambe le sponde del Pacifico: il momento giusto per decidere cosa fare con l’open-weight di frontiera era ieri. Oggi possiamo solo governare quello che uscirà domani. Ed è esattamente quello che, per la prima volta in modo simmetrico, Washington e Pechino stanno provando a fare.
Fonti
- Fanny Potkin, “Exclusive: Beijing is looking at curbing overseas access to China’s top AI models, sources say”, Reuters, 7 luglio 2026. https://www.reuters.com/world/beijing-is-looking-curbing-overseas-access-chinas-top-ai-models-sources-say-2026-07-07/
- “China May Restrict Access to Its Most Powerful AI Models”, TIME, 7 luglio 2026. https://time.com/article/2026/07/07/china-ai-models-alibaba-bytedance/
- “China weighs restrictions on overseas access to its most capable AI models”, Quartz, 7 luglio 2026. https://qz.com/beijing-china-ai-model-export-restrictions-070726
- “China weighs curbing overseas access to its top AI models”, The Next Web, 7 luglio 2026. https://thenextweb.com/news/china-curbing-overseas-access-top-ai-models
- “Alibaba reportedly bans employees from using Claude Code”, TechCrunch, 4 luglio 2026. https://techcrunch.com/2026/07/04/alibaba-reportedly-bans-employees-from-using-claude-code/
- “Alibaba bans Anthropic’s Claude Code after an alleged hidden China-detection backdoor is uncovered”, Tom’s Hardware, 5 luglio 2026. https://www.tomshardware.com/tech-industry/artificial-intelligence/alibaba-bans-anthropics-claude-code-after-an-alleged-hidden-china-detection-backdoor-is-uncovered-employees-told-to-switch-to-qoder-as-the-rift-between-the-firms-widens
- “Alibaba bans employees from using Anthropic’s Claude Code”, Yahoo Tech / The Decoder, 6 luglio 2026. https://tech.yahoo.com/ai/claude/articles/alibaba-bans-employees-using-anthropics-131053680.html
- “Alibaba Bans Claude Code Starting July 10, Pushes In-House Qoder as Replacement”, BigGo Finance, 4 luglio 2026. https://finance.biggo.com/news/a401b1c7-07f5-44e1-9291-cbbd71da342c
- “Alibaba is banning its workers from using Claude Code as US v China AI battle heats up”, TechRadar Pro, 6 luglio 2026. https://www.techradar.com/pro/alibaba-is-banning-its-workers-from-using-claude-code-as-us-v-china-ai-battle-heats-up
- “China Could Restrict Global Access to Alibaba and ByteDance AI Models”, Benzinga, 8 luglio 2026. https://www.benzinga.com/markets/tech/26/07/60326205/china-could-restrict-global-access-to-alibaba-and-bytedance-ai-models-as-beijing-tightens-its-grip-on-advanced-ai-report
Articolo scritto con il supporto di Anthropic Fable 5.
Ogni giorno, decine — a volte centinaia — di persone visitano il tuo sito web. Navigano tra le pagine, leggono i servizi, osservano i case study e poi… spariscono. Nessun contatto, nessuna richiesta, nessuna opportunità concreta per il team commerciale.
È uno scenario comune a moltissime aziende. E il problema non è il traffico: è ciò che succede (o non succede) nel momento in cui un potenziale cliente mostra interesse.
È proprio qui che entra in gioco Dotty, il chatbot AI sviluppato da Synesthesia: un assistente conversazionale intelligente progettato per qualificare lead in modo automatico, naturale e continuo, 24 ore su 24.
Il problema dei chatbot tradizionali
Per anni, le aziende hanno provato a risolvere il problema della lead generation online con strumenti come form di contatto e live chat. I risultati, però, sono spesso deludenti.
I form vengono ignorati perché richiedono troppo impegno, le live chat necessitano di personale dedicato e non garantiscono copertura continua. I chatbot tradizionali, invece, finiscono spesso per creare frustrazione: risposte rigide, percorsi obbligati, incapacità di comprendere domande fuori schema.
Nel frattempo, il team commerciale si ritrova sommerso da richieste poco pertinenti, incomplete o non realmente interessate.
Il costo nascosto? Tempo perso, lead dispersi e opportunità mancate.
Cos’è Dotty
Dotty è un chatbot basato su intelligenza artificiale generativa che conversa con i visitatori del sito come farebbe un vero commerciale.
Non propone semplicemente risposte preimpostate. Comprende il contesto, interpreta le esigenze dell’utente, adatta il tono della conversazione e raccoglie le informazioni necessarie per capire se il contatto rappresenta un’opportunità concreta.
Il risultato è un processo di pre-qualificazione automatico, continuo e perfettamente integrato con il CRM aziendale.
Come funziona
1. Accoglie il visitatore nel momento giusto
Quando un utente arriva sul sito, Dotty compare attraverso un widget discreto e personalizzabile. Con un messaggio di benvenuto naturale e non invasivo, invita il visitatore a raccontare il proprio bisogno.
L’esperienza è immediata e molto più coinvolgente rispetto a un classico form.
2. Conduce una conversazione intelligente
Dotty raccoglie le informazioni essenziali un passo alla volta:
- nome
- azienda
- ruolo
- tipologia di progetto
- budget
- tempistiche
Inoltre Dotty è in grado di leggere documenti PDF allegati durante la conversazione. La conversazione si sviluppa in modo fluido, adattando linguaggio e tono all’interlocutore. Nessun questionario rigido: solo dialogo naturale. Inoltre, il sistema è in grado di distinguere se il visitatore sta rispondendo alle domande di qualificazione oppure se desidera approfondire servizi, portfolio o competenze aziendali. Questo permette una transizione continua tra informazione e qualificazione, senza interrompere l’esperienza utente.
3. Risponde usando la knowledge base aziendale
Uno degli aspetti più evoluti di Dotty è la sua capacità di utilizzare una knowledge base aggiornata in tempo reale.
Il chatbot può rispondere a domande specifiche sui servizi aziendali, sui progetti realizzati o sulle competenze del team attingendo direttamente da documenti caricati dagli amministratori.
Può anche condividere link a case study, portfolio e contenuti rilevanti, offrendo al visitatore informazioni precise e contestualizzate.
4. Consegna lead già qualificati al team commerciale
Al termine della conversazione, Dotty automatizza l’intero processo operativo:
- crea o aggiorna il contatto nel CRM HubSpot;
- genera automaticamente una deal nella pipeline commerciale;
- assegna il lead al commerciale di riferimento;
- invia un’email dettagliata con trascrizione completa, punteggio del lead e informazioni raccolte;
- invia una conferma al potenziale cliente.
Il team sales riceve quindi un lead già qualificato, pronto per essere gestito con una call mirata e contestualizzata.
Perché Dotty è diverso dai chatbot tradizionali
La differenza principale sta nell’approccio. I chatbot tradizionali funzionano seguendo alberi decisionali statici. Se l’utente esce dal percorso previsto, il sistema si blocca o genera risposte poco utili. Dotty, invece, utilizza AI generativa per comprendere il contesto della conversazione e adattarsi dinamicamente.
Questo significa:
- conversazioni più naturali
- maggiore coinvolgimento
- raccolta dati più efficace
- meno abbandoni
- lead di qualità superiore
E soprattutto: meno tempo perso dal team commerciale.
I casi d’uso ideali
Dotty si adatta particolarmente bene a contesti in cui la fase di pre-qualificazione richiede tempo o competenze specifiche.
È ideale per:
- software house
- agenzie digitali
- aziende SaaS B2B
- società di consulenza
- e-commerce con richieste personalizzate
- team commerciali che vogliono copertura continua anche fuori orario
In pratica, tutte le realtà che ricevono richieste eterogenee e vogliono trasformare il traffico del sito in opportunità concrete.
Le metriche che Dotty aiuta a migliorare
Implementare Dotty significa poter misurare concretamente:
- aumento del tasso di conversione visitatore → lead qualificato
- riduzione dei tempi di risposta da ore a secondi
- miglioramento della qualità dei lead
- copertura commerciale anche fuori orario lavorativo
- riduzione del tempo speso nella pre-qualificazione manuale
Il futuro della lead generation è conversazionale
I visitatori non vogliono più compilare form impersonali o aspettare giorni per ricevere una risposta.
Vogliono interazioni immediate, pertinenti e naturali. Dotty nasce esattamente per questo: trasformare il sito web da semplice vetrina a strumento attivo di vendita, capace di ascoltare, comprendere e qualificare ogni opportunità in tempo reale.
Per richiedere una demo personalizzata o approfondire il funzionamento di Dotty scrivici a ciao@synesthesia.it o a francesco.ronchi@synesthesia.it. Ti aspettiamo!
Oggi si parla molto di AI applicata alla customer experience. Qual è il principale cambiamento che stiamo osservando rispetto ai chatbot tradizionali?
Il cambiamento principale riguarda certamente il passaggio da interazioni guidate a conversazioni realmente intelligenti. Oggi l’utente si aspetta risposte rapide, pertinenti e soprattutto contestualizzate. I chatbot tradizionali funzionavano bene su richieste semplici e prevedibili, mentre l’AI introduce la capacità di comprendere l’intento e gestire conversazioni più articolate. Questo cambia completamente il ruolo del chatbot: da strumento di supporto a vero punto di interazione strategica.
Synesthesia ha recentemente lanciato Dotty, un AI Sales Chatbot pensato per trasformare il sito web da semplice canale informativo a vero strumento commerciale. Cosa lo rende diverso dai chatbot tradizionali e perché rappresenta un’evoluzione così significativa?
Dotty nasce per portare l’interazione con il sito web su un livello commerciale evoluto. Utilizza AI generativa per gestire conversazioni naturali e guidare l’utente in un percorso strutturato di qualificazione del lead, adattando domande e tono in base alle risposte ricevute.
La differenza rispetto ai chatbot tradizionali sta nell’approccio e nell’obiettivo. I chatbot classici seguono flussi rigidi e raccolgono informazioni in modo frammentato; Dotty, invece, costruisce una conversazione continua che permette di comprendere il contesto, intercettare le reali esigenze e arricchire progressivamente il profilo del potenziale cliente.
Durante l’interazione raccoglie e struttura informazioni chiave come tipologia di progetto, budget, tempistiche e livello di interesse, arrivando a generare un lead già qualificato e pronto per essere gestito dal team commerciale. Il tutto integrandosi direttamente con il CRM aziendale, dove crea contatti e opportunità in modo automatico.
In questo modo il sito smette di essere un punto di passaggio passivo e diventa un canale attivo di generazione e qualificazione delle opportunità commerciali, capace di lavorare in continuità con il team sales.
Il risultato è diretto e misurabile: meno richieste poco rilevanti, meno tempo perso in attività a basso valore e un aumento dei lead realmente interessanti. In altre parole, un commerciale digitale sempre attivo, capace di lavorare 24 ore su 24 senza lasciare indietro nessuna opportunità.
Come cambia, in concreto, il ruolo del sito web nel processo di vendita?
Il sito diventa il primo punto di attivazione del processo commerciale. Chi arriva non si limita più a navigare contenuti, ma entra in una conversazione che lo accompagna subito verso i propri obiettivi.
Per esempio, un utente che approda sul sito e richiede informazioni su un servizio può avviare un dialogo diretto con Dotty, che la guida con domande mirate su esigenze, tempistiche e contesto del progetto, fino a costruire un profilo chiaro da condividere con il team commerciale.
Questo approccio rende il sito parte attiva della pipeline commerciale: intercetta l’interesse nel momento in cui nasce e lo traduce in un’opportunità già strutturata, riducendo la distanza tra curiosità e contatto qualificato.
Uno degli aspetti centrali di Dotty è la capacità di qualificare i lead in tempo reale. Che impatto ha questo sul lavoro dei team marketing e sales?
Il beneficio principale è la qualità dell’informazione che arriva ai team. Il marketing ottiene un canale capace di generare lead già profilati, mentre il team sales riceve contatti con contesto chiaro: esigenze, tempistiche, budget e livello di interesse.
Questo cambia anche il modo in cui vengono gestite le priorità. Il lavoro si sposta dalla raccolta e filtraggio dei contatti alla gestione diretta delle opportunità più rilevanti, con un impatto evidente sull’efficienza complessiva del processo commerciale.
Inoltre, la disponibilità immediata di dati strutturati permette di ridurre i tempi tra primo contatto e follow-up, aumentando la velocità di risposta e la qualità dell’interazione con il potenziale cliente. Il risultato è un flusso più ordinato tra marketing e sales, in cui ogni team lavora su informazioni più affidabili e allineate agli obiettivi commerciali.
Guardando avanti, come immagini l’evoluzione degli AI chatbot all’interno delle strategie digitali delle aziende nei prossimi anni?
L’evoluzione degli AI chatbot sarà sempre più legata alla capacità delle aziende di integrare conversazione e dati in un unico flusso continuo di valore. Gli AI chatbot diventeranno un’infrastruttura stabile all’interno degli ecosistemi digitali delle aziende, non più uno strumento “a supporto”, ma un punto di accesso diretto ai processi commerciali e di relazione con il cliente.
Per le aziende tecnologiche questo significa passare da logiche basate su touchpoint statici a sistemi conversazionali continui, capaci di intercettare intenzioni, qualificare richieste e attivare in tempo reale i processi interni: marketing, sales e customer care.
La direzione è quella di un’interazione sempre più integrata con i dati aziendali e i sistemi CRM, dove il valore sta nella capacità di trasformare quella conversazione in insight e opportunità operative.
In questo scenario, soluzioni come Dotty rappresentano un primo livello di evoluzione tangibile: sistemi che iniziano a collegare in modo diretto esperienza utente e obiettivi di business, rendendo la componente conversazionale un asset strategico della crescita digitale.
Vuoi scoprire come Dotty può supportare la tua azienda? Scrivici per ricevere maggiori informazioni.
Nell’era dell’AI, il vero vantaggio competitivo resta profondamente umano: agency, relations e taste. La capacità di prendere iniziativa e decisioni, costruire relazioni significative e sviluppare senso critico e gusto diventa ciò che guida e dà valore all’uso delle tecnologie.
Agency: leadership, responsabilità e capacità decisionale
In un mondo in cui l’AI suggerisce sempre qualcosa, la vera competenza non è “avere una risposta”, ma decidere quale risposta ha senso per noi e per il contesto in cui lavoriamo.
Agency significa:
- non limitarsi a chiedere cose all’AI, ma definire la direzione
- sapere quando fidarsi del modello e quando fermarsi e fare una verifica
- prendersi la responsabilità di una scelta, anche se il prompt diceva altro
- usare i tool per esplorare opzioni, non per scaricare la colpa su un algoritmo
L’AI è potentissima nel generare alternative, simulare scenari, portare insight che non vedremmo da soli. Ma alla fine qualcuno deve avere il coraggio e la responsabilità di dire: “andiamo di qua, non di là”.
Cosa significa questo per chi lavora nel digitale?
- uno sviluppatore con agency non usa solo l’AI per completare il codice, negozia i requisiti, propone un’architettura diversa, si prende carico delle implicazioni di manutenzione;
- una persona di marketing con agency non si limita a chiedere “scrivimi un post”, ma sceglie il posizionamento, definisce i confini etici, decide cosa non dire;
- un consulente con agency non presenta solo dashboard e analisi generate con AI, racconta una tesi e si mette in gioco rispetto al cliente
Insomma, agency è il contrario dell’autopilota: è la capacità di usare l’AI come leva, non come stampella.
Relations: fiducia e partnership nell’era dei tool standardizzati
Se gli strumenti diventano simili per tutti, la relazione diventa il vero vantaggio competitivo. Possiamo avere le stesse piattaforme di AI, ma non abbiamo le stesse conversazioni, lo stesso livello di fiducia, la stessa profondità di partnership con clienti, colleghi, partner.
Per noi relations significa:
- saper costruire fiducia nel tempo, non solo eseguire progetti;
- passare da fornitore a partner, cioè qualcuno che capisce il contesto del cliente e lo porta nel tempo dentro le soluzioni;
- saper porre domande migliori, non solo portare risposte generate da un modello;
- gestire conflitti, aspettative, paure legate all’adozione dell’AI
In pratica?
- due aziende possono usare gli stessi tool per fare chatbot, analisi dati, automazioni. Quella che vince è quella che conosce meglio il proprio cliente, i suoi vincoli, la sua cultura interna, e sa accompagnarlo nel cambiamento;
- all’interno dei team, la differenza non la fa chi ha l’ultimo plugin di turno, ma chi sa collaborare, far circolare conoscenza, contaminare competenze (dev, marketing, operations, strategia);
- nei progetti complessi, l’AI può generare slide, report, mockup. Ma è la relazione consulente – cliente che decide se quelle proposte verranno ascoltate davvero
L’era dei tool standardizzati alza l’asticella sul piano tecnico, ma apre ancora di più lo spazio per chi sa creare relazioni solide e di lungo termine.
Taste: cultura, gusto e qualità dell’esperienza digitale
L’AI può generare praticamente tutto: interfacce, copy, palette colori, architetture informative, naming, flussi. Ma non sa ancora dire cosa è davvero “giusto” per un brand, per un prodotto, per una situazione specifica.
Qui entra in gioco il taste: una combinazione di cultura, sensibilità estetica, conoscenza del contesto, cura dei dettagli.
Taste non è solo “avere gusto”, ma:
- saper riconoscere cosa è coerente con l’identità di un brand e cosa non lo è;
- capire la differenza tra qualcosa che “funziona” e qualcosa che crea un’esperienza memorabile;
- sapere quando un output dell’AI è adeguato e quando è “cheap”;
- avere abbastanza cultura da ispirare l’AI nella direzione giusta
Nel digitale questo si traduce in esempi molto concreti:
- due interfacce generate con gli stessi tool di design assistito dall’AI possono avere lo stesso layout ma una qualità percepita completamente diversa, per micro-scelte di tipografia, spacing, tono di voce;
- un flusso di onboarding può essere tecnicamente corretto, ma privo di empatia. Il taste aiuta a capire qual è il ritmo giusto, dove togliere attrito, dove mettere un tocco di umanità;
- un articolo o una campagna pensati con l’AI possono essere formalmente ineccepibili, ma piatti. Serve qualcuno che dica: “ok, questa è la base, adesso portiamola a un livello che ci assomigli davvero”
L’AI amplifica quello che c’è. Se all’origine c’è poco gusto, poca cultura, poca cura, amplificherà anche quello. Se invece alla base c’è un forte senso di qualità, i tool generativi diventano moltiplicatori di questo valore.
Perché l’AI non sostituisce il contesto e la visione sistemica
Infine, l’Intelligenza Artificiale è in grado di generare codice, immagini, testi, analisi. Può accelerare attività complesse e automatizzare processi che fino a ieri richiedevano ore di lavoro umano. Ma c’è una dimensione che non riesce a padroneggiare davvero: il contesto.
L’AI non comprende la politica interna di un’organizzazione, gli equilibri tra funzioni, le dinamiche implicite che guidano le decisioni. Non percepisce i vincoli organizzativi non scritti, le priorità di business che cambiano in base a strategie, budget o pressioni di mercato. Non legge tra le righe delle relazioni umane, né coglie pienamente il contesto culturale in cui un’azienda opera.
Può elaborare informazioni, ma non vive le conseguenze delle decisioni. Può proporre soluzioni, ma non ne assume la responsabilità. Per questo il futuro del lavoro non sarà meno umano. Al contrario, sarà più umano.
Le persone che avranno successo non saranno semplicemente quelle che sapranno usare gli strumenti di AI, ma quelle capaci di integrarli dentro una visione più ampia. Servirà combinare competenze tecniche solide con una visione sistemica, comprendere il dominio del business, saper comunicare in modo efficace e mantenere una curiosità continua verso ciò che evolve.
Emergerà una figura sempre più interdisciplinare, quasi rinascimentale: professionisti capaci di attraversare tecnologia, strategia, organizzazione e cultura con naturalezza. Non specialisti isolati, ma connettori di competenze.
Il 2026 non sarà l’anno in cui l’AI sostituirà il lavoro. Sarà l’anno in cui ridefiniremo cosa significa lavorare, creare valore e costruire il futuro. E questa non è una previsione inevitabile. È una scelta.
Stai valutando come introdurre l’AI nella tua organizzazione in modo strutturato? Scopri come diventare AI Ready e affrontare il futuro del lavoro con strategia e visione.Parliamone.
Il 2026 segna un punto di svolta nel rapporto tra Intelligenza Artificiale e lavoro. Dopo anni di hype e sperimentazione, l’AI non è più una tecnologia emergente: è un’infrastruttura diffusa, accessibile e quotidiana. Non siamo più nella fase del “se”, ma del “come”.
L’AI è ovunque: nei processi aziendali, nei flussi operativi, nelle piattaforme che utilizziamo ogni giorno. Non riguarda solo i team tech, ma marketing, consulenza, operations e management. Come già accaduto con il computer negli anni ’80 e con Internet negli anni 2000, oggi l’Intelligenza Artificiale è diventata parte del contesto.
La vera domanda, quindi, non è se l’AI sostituirà il lavoro, ma:
che tipo di lavoro vogliamo costruire nell’era dell’AI?
Perché sovra-stimiamo l’AI nel breve periodo (e la sotto-stimiamo nel lungo)
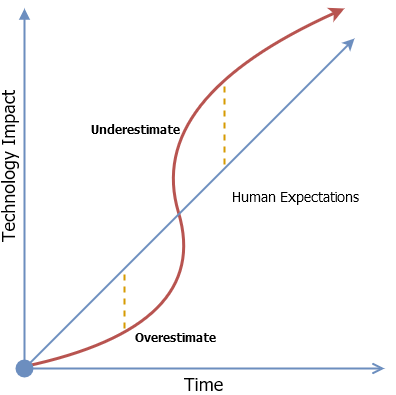
La storia dell’innovazione tecnologica ci insegna che ogni grande rivoluzione attraversa lo stesso ciclo: entusiasmo, disillusione, integrazione, trasformazione.
Come ricorda la legge di Amara, nel breve periodo tendiamo a sovrastimare l’impatto dell’AI. Ci aspettiamo cambiamenti immediati, radicali, spesso irreali. Nel lungo periodo, invece, sottovalutiamo quanto la tecnologia modificherà profondamente modelli di business, ruoli professionali e competenze.
Oggi siamo in una fase intermedia. L’AI non sta distruggendo il lavoro, ma lo sta ridefinendo. Le aziende che sapranno attraversare questa fase con lucidità e strategia saranno quelle che costruiranno il vantaggio competitivo dei prossimi anni.
AI-Augmented Work: come cambia il lavoro quotidiano
La prima trasformazione è già in atto: il lavoro diventa AI-augmented. Significa che l’Intelligenza Artificiale entra nei processi quotidiani come supporto operativo:
- Generazione di contenuti e asset creativi;
- Coding assistito e completamento del codice;
- Analisi, ricerche e insight strategici;
- Automazione di task ripetitivi;
- Produzione di presentazioni e documentazione;
- SEO per l’AI e ottimizzazione dei contenuti per modelli linguistici;
- Chatbot e assistenti interni.
Questo livello è ormai uno standard minimo. Chi non utilizza l’AI è in ritardo. Chi la utilizza è semplicemente allineato al mercato. Il vero salto di valore avviene altrove.
Game-Changing AI: dove si crea davvero valore
Il vantaggio competitivo nasce quando l’AI non è solo un supporto, ma diventa parte della proposta di valore. Qui si colloca la Game-Changing AI: quella che crea nuovi prodotti, nuovi servizi e nuovi modelli di business.
Fast Follower o Front Runner? Il posizionamento strategico nell’era dell’AI
Ogni azienda, oggi, è chiamata a scegliere come stare nel cambiamento guidato dall’Intelligenza Artificiale. Non è solo una decisione tecnologica, ma una scelta di identità strategica.
C’è chi decide di essere fast follower: osserva il mercato, analizza le sperimentazioni altrui, seleziona le soluzioni più mature e le adotta con pragmatismo. È un approccio orientato alla riduzione del rischio, alla solidità, alla scalabilità controllata.
Altri scelgono di essere front runner: sperimentano per primi, si assumono il rischio dell’errore, aprono nuove strade. Investono in ricerca, esplorano territori inesplorati, accettano l’incertezza come parte del vantaggio competitivo.
Nella realtà, però, poche organizzazioni possono permettersi una scelta radicale e unica. La maggior parte dovrà muoversi su entrambi i fronti: stabilità e controllo sui processi core, innovazione spinta nelle aree ad alto potenziale.
La vera discriminante non è la velocità con cui si adotta una tecnologia, ma la capacità di diventare AI Ready.
Cosa significa essere “AI Ready” per un’azienda digitale
Essere pronti all’AI non significa acquistare nuovi tool o attivare una piattaforma. Significa trasformare l’organizzazione in profondità.
Vuol dire sviluppare competenze, strutture, governance e cultura in grado di integrare l’Intelligenza Artificiale nei processi quotidiani. È un percorso evolutivo (non un progetto a tempo) che comprende:
- formazione continua e condivisione delle conoscenze;
- policy chiare;
- investimenti in ricerca e sviluppo;
- riformulazione di processi e modelli interni al team;
- trasformazione dei workflow;
- creazione di valore concreto per i clienti.
Essere pronti, dunque, vuole dire avere dati organizzati, infrastrutture adeguate e competenze interne per integrare l’intelligenza artificiale nei processi aziendali.
Stai valutando come introdurre l’AI nella tua organizzazione in modo strutturato? Scopri come diventare AI Ready e affrontare il futuro del lavoro con strategia e visione. Parliamone.
Michela, qual è il livello di maturità del mercato e-commerce italiano nell’adozione di AI generativa e ricerca avanzata, rispetto ad altri Paesi?
L’Italia vive un paradosso. Siamo sicuramente indietro rispetto al mercato nordamericano e nordeuropeo sull’adozione di infrastrutture avanzate e sulla mentalità data-driven. Molte delle aziende italiane sono ancora legate a processi legacy e a una gestione intuitiva del magazzino e del marketing. Altre aziende poi, anche di grandi dimensioni, operano ancora con silos informativi: l’ERP non parla con il CRM, che a sua volta è scollegato dal magazzino e dalle piattaforme e-commerce.
Senza un’infrastruttura dati fluida e pulita, l’AI Search o i sistemi predittivi rimangono gusci vuoti. In questo senso forse il nostro ritardo non è nella mancanza di interesse verso l’AI, ma nella mancanza delle fondamenta necessarie per farla funzionare: l’accessibilità e la qualità del dato.
La dimensione media delle imprese italiane poi è un freno naturale agli investimenti massivi in R&D. Questo ritardo ci offre però l’opportunità del leapfrogging: saltare intere generazioni tecnologiche. Molte aziende stanno passando direttamente da processi manuali o legacy a soluzioni AI-native, evitando di dover ammortizzare tecnologie intermedie ormai superate. In questo, il punto critico da considerare c’è: saltare le generazioni tecnologiche è possibile dal punto di vista del software, ma non per le persone; un team che non ha mai masticato la cultura del dato (anche banalmente su Excel o su un semplice CRM) farà fatica a comprendere un’AI predittiva. Il salto tecnologico dovrà quindi necessariamente essere supportato da un upskilling.
Quali rischi comporta l’adozione dell’AI generativa per le vendite online? Come si possono gestire?
Il primo rischio, forse quello più immediato, è quello legato alle cosiddette “allucinazioni”.
Dobbiamo ricordare che l’AI non sa le cose, le calcola: se il modello non è correttamente vincolato ai dati reali del catalogo e soprattutto se i dati di partenza non sono ben strutturati, rischia di generare promesse che l’azienda non può mantenere, come inventare caratteristiche tecniche o funzionalità inesistenti. Questo non si traduce solo in un aumento dei resi e in potenziali problemi legali, ma mina la base stessa del commercio: la fiducia tra cliente e brand. Se tradiamo questa fiducia con un’informazione errata composta da un algoritmo, recuperare l’utente diventa difficilissimo.
C’è poi un tema più sottile ma altrettanto pericoloso: l’erosione dell’identità del brand.
Se deleghiamo interamente la generazione dei contenuti e l’interazione con l’utente all’AI, corriamo il rischio di una standardizzazione linguistica e creativa. In particolari mercati in cui il tone of voice è uno dei pochi veri elementi differenzianti, il pericolo è quello di finire per suonare tutti allo stesso modo. Ad esempio un e-commerce di lusso e un fast-fashion non possono avere la stessa voce, e mantenere questo controllo sul contenuto e l’interazione con le persone è una sfida che richiede una supervisione umana costante.
Per alcuni casi specifici non dobbiamo poi sottovalutare la dipendenza tecnologica: affidare i pilastri del proprio business a modelli di terze parti significa di fatto cedere una fetta della propria sovranità aziendale e avere un impatto diretto e immediato sui margini e sull’operatività. Il nostro compito è quindi quello di accompagnare i nostri clienti nell’integrare l’AI in modo intelligente, mantenendo sempre il controllo sulla strategia.
L’introduzione dell’AI generativa richiede una ristrutturazione dei team e-commerce, oppure un’evoluzione di ruoli, competenze e responsabilità?
Più che di una ristrutturazione, io vedo la necessità di un’evoluzione della responsabilità. Dal punto di vista operativo, chi si occupa di caricare schede prodotto o gestire flussi di reso deve trasformarsi in un curatore del dato, dandosi anche il compito di istruire l’AI e validarne gli output. Se l’algoritmo suggerisce un prodotto o genera una risposta, il team deve avere la competenza strategica per capire se quell’output è coerente con gli obiettivi aziendali e l’identità del brand.
Il ruolo dell’ E-Commerce Strategist diventa ancora più centrale come connettore. Dobbiamo essere in grado di tradurre le opportunità dell’AI (tecniche) in vantaggi di business (strategici). Questo richiede team più agili, in cui la barriera tra chi “capisce il codice” e chi “capisce il cliente” cade definitivamente.
A livello decisionale poi, con l’AI che accelera i processi, il collo di bottiglia rischia di diventare la burocrazia decisionale umana. I team devono quindi strutturarsi per essere reattivi in poco tempo: se i dati della AI Search ci dicono che c’è un trend emergente non possiamo aspettare lunghi processi decisionali per ricalibrare il merchandising.
In sostanza, dal punto di vista della gestione dei team, la vera sfida non è tecnologica ma culturale e organizzativa: in un sistema in cui la tecnologia sta diventando una commodity accessibile a tutti, l’unico vero vantaggio competitivo non sarà possedere l’AI, ma avere un team capace di integrarla nei processi con intelligenza senso critico.
Synesthesia offre una consulenza completa in ambito e-commerce per aiutare la tua azienda a raggiungere i propri obiettivi di business e incrementare le tue vendite. Ti accompagniamo passo dopo passo, curando ogni aspetto della tua presenza online, e forniamo supporto specifico per far crescere la tua attività, massimizzando l’efficienza e l’ottimizzazione di tutti i processi operativi. Contattaci per scoprire come possiamo valorizzare il tuo e-commerce.
Succede quasi sempre, in qualunque riunione in cui si parla di adottare l’intelligenza artificiale in azienda. A un certo punto qualcuno alza la mano e chiede: “ma i nostri dati dove vanno?”
E lì il progetto rallenta. A volte si blocca del tutto.
Quella domanda è legittima. Anzi, è la domanda giusta — perché chi la fa sta facendo il suo lavoro. Il problema non è il dubbio, ma la risposta che spesso segue: rinunciare all’AI, o rimandare a data da destinarsi, in attesa che “la situazione si chiarisca”.
La situazione è già abbastanza chiara. I rischi esistono, sono concreti, e si possono gestire. Non con un atto di fede nel provider di turno, ma con scelte architetturali precise, una governance seria e la consapevolezza che sicurezza e innovazione non sono in contraddizione — a patto di non lasciare le cose al caso.
I rischi reali, senza allarmismi
Partiamo da quello che preoccupa davvero le aziende, senza edulcorare.
Il primo timore è il data leakage: informazioni sensibili inserite nei prompt, dati aziendali usati per interrogare un modello, output che potrebbero contenere — o rivelare — informazioni riservate. È un rischio concreto, soprattutto quando i dipendenti usano strumenti AI pubblici e gratuiti senza che l’IT ne sia a conoscenza. Questo fenomeno ha anche un nome: shadow AI, ed è probabilmente il rischio più sottovalutato nelle organizzazioni oggi.
Poi c’è il tema della compliance: GDPR e AI Act pongono requisiti precisi su come i dati personali vengono trattati, con chi vengono condivisi, chi è responsabile delle decisioni automatizzate. Non sono dettagli tecnici — sono obblighi normativi con conseguenze reali.
Infine, la dipendenza da provider esterni: affidarsi completamente a un servizio di terze parti significa accettare le loro condizioni contrattuali, la localizzazione dei loro server, la loro continuità operativa. Per alcune aziende, in alcuni settori, questo è semplicemente inaccettabile.
Tutto questo è reale. Ma nessuno di questi problemi è irrisolvibile. E soprattutto, nessuno di questi problemi giustifica di restare fermi.
Il malinteso che blocca tutto
C’è una convinzione diffusa che vale la pena smontare: l’idea che la sicurezza sia una proprietà del modello AI in sé — che certi strumenti siano “sicuri” e altri no, per natura.
Non funziona così.
La sicurezza dell’AI non dipende dal modello. Dipende dall’architettura con cui viene integrato, dai processi che lo governano, dalle scelte che vengono fatte su dove girano i dati e chi vi ha accesso. ChatGPT usato in modo non governato da un dipendente che incolla dentro un contratto riservato è un problema serio. Lo stesso modello, integrato tramite API enterprise con logging, controllo degli accessi e policy di utilizzo definite, è tutt’altra cosa.Questo è il cambio di prospettiva fondamentale: smettere di chiedersi “è sicuro usare l’AI?” e iniziare a chiedersi “come la progettiamo per renderla sicura?”
Le tre strade: quale si adatta alla tua situazione
Non esiste una soluzione universale. Esistono approcci diversi, con livelli diversi di controllo, complessità e costo — e la scelta giusta dipende da chi sei, da che dati tratti, da quanto è critico il contesto in cui operi.
La prima strada sono le API enterprise dei grandi provider. OpenAI, Anthropic, Microsoft Azure OpenAI: tutte queste piattaforme offrono modalità d’uso professionali in cui i dati non vengono utilizzati per addestrare i modelli, i tenant sono isolati, e sono disponibili strumenti di logging e gestione degli accessi. Per molte aziende — anche con dati sensibili — questa è già una soluzione adeguata, soprattutto se abbinata a una buona governance interna. I vantaggi sono chiari: velocità di implementazione, affidabilità, sicurezza gestita da provider che investono centinaia di milioni di dollari in questo. Lo svantaggio è che i dati transitano comunque su infrastrutture esterne.
La seconda strada è il private cloud, o VPC (Virtual Private Cloud). Qui l’azienda mantiene un ambiente cloud dedicato e isolato — tipicamente su Azure, AWS o Google Cloud — in cui il modello AI viene deployato in un perimetro sotto il suo controllo. È la soluzione ideale per chi ha bisogno di scalabilità cloud ma non può o non vuole che i propri dati escano da un ambiente governato internamente. È la scelta frequente in settori come finance, healthcare, utilities, e in molti contesti della pubblica amministrazione.
La terza strada è il modello open source on-premise. Oggi esistono modelli di qualità elevata — Mistral, LLaMA, e altri — che possono essere installati e fatti girare su infrastruttura completamente controllata dall’azienda, senza che nessun dato esca mai dal perimetro aziendale. Nessuna chiamata a server esterni, nessuna dipendenza da provider, nessuna questione di localizzazione dei dati. Il controllo è totale. La complessità e i costi infrastrutturali sono più alti, ma per i contesti ad alta criticità — uno studio legale, un ospedale, una società che gestisce infrastrutture critiche — questa può essere l’unica opzione accettabile.
Il punto non è quale sia la soluzione migliore in assoluto. Il punto è capire qual è quella giusta per il tuo contesto specifico.
La parte che le aziende dimenticano: la governance
La tecnologia, da sola, non basta.
Puoi avere l’architettura più sicura del mondo, ma se i tuoi dipendenti non sanno quali strumenti sono autorizzati, se non esistono policy sull’uso dell’AI, se nessuno monitora come vengono usati i sistemi, hai comunque un problema.
Le aziende più avanzate su questo fronte stanno costruendo veri e propri AI governance framework: chi può usare cosa, su quali dati, con quali finalità, con quali controlli. Non è burocrazia — è il modo in cui l’AI smette di essere un esperimento e diventa un asset aziendale gestito con serietà.
Questo include formazione per i dipendenti, definizione dei casi d’uso autorizzati, audit periodici, e un allineamento costante con le funzioni legali e di compliance. È un lavoro organizzativo, non solo tecnologico. Ed è spesso il tassello mancante.
Restare fermi ha un costo
C’è una tentazione comprensibile: aspettare. Aspettare che le normative si stabilizzino, che i provider diventino “più sicuri”, che il mercato si assesti. Nel frattempo, non fare nulla.
Ma non fare nulla non è una posizione neutrale. È una scelta. E ha un costo — spesso invisibile nell’immediato, ma concreto nel tempo.
Le aziende che stanno affrontando oggi il tema della sicurezza AI con metodo non si stanno solo proteggendo dai rischi. Si stanno attrezzando per competere: processi più efficienti, servizi migliori, capacità di innovare più velocemente. Chi resta fermo per paura rischia di trovarsi tra qualche anno in una posizione difficile da recuperare.
Vale la pena ricordarlo: dieci anni fa molte aziende avevano le stesse perplessità sul cloud. Dati fuori dall’azienda, dipendenza da provider, rischi di sicurezza. Quelle perplessità erano, in parte, fondate. Ma le aziende che le hanno affrontate con metodo — invece di usarle come argomento per non muoversi — sono quelle che oggi hanno un vantaggio strutturale. Con l’AI, la storia si sta ripetendo.
Come lavoriamo su questo in Synesthesia
Quando un’azienda ci porta questo tema — e succede spesso, quasi sempre all’inizio di un progetto — il nostro punto di partenza non è la tecnologia, ma il contesto. Che dati entrano in gioco? Qual è il livello di criticità? Esistono vincoli normativi specifici? Quanto è maturo internamente il tema della governance?
Da lì, progettiamo l’architettura più adatta: API enterprise per chi ha bisogno di velocità e affidabilità, ambienti su cloud privato per chi richiede isolamento, soluzioni open source on-premise per i contesti più critici. E affianchiamo le organizzazioni anche sul piano della governance — policy, formazione, definizione dei processi.
L’obiettivo è sempre lo stesso: rendere possibile l’innovazione senza che sicurezza e privacy diventino un freno. Perché non devono esserlo.
Stai valutando come introdurre l’AI nella tua organizzazione in modo sicuro e strutturato? Parliamone.
Un nuovo obbligo, una nuova opportunità
L’articolo 4 impone a fornitori e utilizzatori di sistemi di intelligenza artificiale l’obbligo di garantire un livello adeguato di alfabetizzazione in materia di AI per tutti coloro che, a vario titolo, lavorano con o attorno a queste tecnologie.
Non si tratta solo di un adempimento normativo, ma di una leva strategica per aumentare la consapevolezza, migliorare la governance dei dati e ridurre i rischi legati all’uso improprio o inconsapevole dell’intelligenza artificiale.
Cosa devono fare le aziende?
Le aziende sono tenute a costruire percorsi formativi coerenti con:
- Le conoscenze tecniche e l’esperienza delle persone coinvolte.
- Il contesto specifico in cui l’AI viene applicata.
- I gruppi di utenti o stakeholder su cui l’AI può avere impatto.
L’obiettivo? Promuovere un uso informato e responsabile dell’intelligenza artificiale, valorizzandone i benefici e gestendone i rischi.
Le best practice per un piano formativo efficace
In base alla nostra esperienza diretta in progetti di trasformazione digitale e formazione e secondo le best practices pubblicate dalla Commissione Europea, ecco alcune strategie vincenti per rispettare l’Articolo 4 e allo stesso tempo generare valore per l’organizzazione:
- Formazione personalizzata: strutturare i percorsi in base alle funzioni aziendali (management, team tecnici, operation…) e al livello di competenza individuale.
- Approccio modulare: partire da una sessione introduttiva per tutti, per poi approfondire con workshop verticali e moduli avanzati mirati.
- Coinvolgimento trasversale: integrare competenze legali, tecnologiche e strategiche per offrire una visione completa delle implicazioni dell’AI.
- Monitoraggio e aggiornamento: verificare l’efficacia della formazione con strumenti di valutazione e aggiornare i contenuti in base all’evoluzione normativa e tecnologica.
Casi reali: cosa stanno facendo le aziende
Abbiamo osservato da vicino diverse realtà – sia corporate che PMI – che hanno già iniziato a implementare iniziative strutturate in questa direzione. Ecco alcuni modelli ricorrenti:
- Accademie digitali e piattaforme e-learning con percorsi distinti per profili funzionali (data scientist, AI translator, business analyst…), indipendentemente dal reparto di appartenenza.
- Progetti di reskilling e upskilling in collaborazione con università e tech provider, che combinano moduli tecnici sull’AI generativa con aspetti legali e di compliance.
- Bootcamp intensivi e workshop pratici pensati per i team di R&D e sviluppo prodotto, suddivisi per livello di esperienza.
- Programmi di AI responsabile, focalizzati su etica, trasparenza e uso sicuro dei dati, in contesti ad alta intensità informativa.
- Formazione gamificata per aumentare il coinvolgimento dei team operativi, con simulazioni, quiz interattivi e sfide collaborative.
Synesthesia: formazione, consulenza e soluzioni AI, tutto in uno
In Synesthesia lavoriamo da tempo al fianco delle aziende per progettare percorsi formativi su misura, affiancati da soluzioni tecnologiche integrate che rendano l’AI davvero accessibile, utile e sostenibile.
Dal design dei contenuti alla formazione interattiva, dalla consulenza legale alle piattaforme su misura, possiamo accompagnarti nell’adeguamento all’AI Act e, soprattutto, nella costruzione di una cultura aziendale che sfrutti l’intelligenza artificiale per innovare davvero.
Vuoi saperne di più o iniziare un assessment del tuo piano formativo?
Contattaci, siamo pronti ad accompagnarti nel cambiamento.
Autore: Davide Mantovani, (Web & AI Platform Leader di Synesthesia)
Non è ormai un segreto che il settore dell’intelligenza artificiale generativa, tradizionalmente dominato dai colossi americani della Silicon Valley e dalla loro corsa a modelli linguistici sempre più complessi, sia recentemente stato scosso da un terremoto oltreoceano chiamato DeepSeek.
Fondata nel luglio 2023 da Liang Wenfeng, la startup cinese ha meno di due anni e non si limita a inseguire i competitor gattonando, ma cerca di ridefinire le regole del gioco, dimostrando come efficienza architetturale, adozione strategica dell’open source e un focus sul ragionamento strutturato, possano rappresentare un’alternativa vincente al paradigma della mera dimensione computazionale.
DeepSeek ha fatto di necessità virtù
DeepSeek ha scelto una strada controcorrente rispetto alla tendenza dominante del settore: invece di investire in infrastrutture hardware esorbitanti per addestrare modelli con miliardi di parametri, ha puntato sull’ottimizzazione dell’architettura. Questo approccio, combinato con tecniche avanzate di apprendimento per rinforzo – inclusa la sperimentazione con il reinforcement learning senza feedback umano, un primato nel settore – ha portato a risultati significativi.
In questo contesto, il ruolo delle restrizioni imposte dal Governo degli Stati Uniti sull’esportazione di tecnologie avanzate – incluse le richiestissime GPU Nvidia di fascia alta – verso la Cina non è da sottovalutare. Questi limiti hanno creato una situazione di necessità per le aziende coinvolte, spingendole a ottimizzare l’architettura dei loro modelli e a sviluppare chip nazionali. Aggiungiamo a questa ricetta un pizzico di limitazione all’ottenimento di informazioni che possono essere consumate in Cina e otteniamo DeepSeek.
L’azienda cinese ha presentato alcuni modelli, ma l’attenzione si è concentrata su R1, un modello in grado di elaborare le informazioni in seguito ad un ragionamento strutturato (come i cosiddetti “thinking models” OpenAI o1 e o3 e Google Gemini 2.0), seguendo catene di ragionamento (Chain-of-Thought, CoT) e alberi di pensiero (Tree-of-Thoughts, ToT). CoT incoraggia il modello a generare una serie di passaggi di ragionamento intermedi prima di produrre la risposta finale a una domanda, mentre ToT ne espande la struttura promuovendo catene di ragionamento parallele.
Segue un esempio.
Domanda: un fruttivendolo ha 10 mele. Ne vende 2 al mattino e 3 al pomeriggio. Quante mele gli rimangono?
Catena di ragionamento:
1. Il fruttivendolo inizia con 10 mele.
2. Ne vende 2 al mattino, quindi gliene rimangono 10 – 2 = 8.
3. Ne vende 3 al pomeriggio, quindi gliene rimangono 8 – 3 = 5.
Risposta finale: al fruttivendolo rimangono 5 mele.
Come è stato addestrato il modello di DeepSeek?
La necessità di ridurre la dipendenza dalle enormi quantità di dati necessarie a completare un apprendimento completo e di ricorrere a infrastrutture estremamente potenti, ha creato la necessità di ricorrere a una combinazione di tecniche di learning avanzate.
DeepSeek sostiene di aver utilizzato, per l’addestramento del modello principale (R1), solo chip di vecchia generazione e dalle prestazioni limitate (Nvidia H800 e A100), così da rispettare le restrizioni tecnologiche imposte dagli Stati Uniti. Una scelta in contrasto con l’uso delle più potenti e costose GPU H100, che riflette la strategia dell’azienda di puntare più sull’ottimizzazione software che sulla potenza hardware. Detto questo, è doveroso specificare che non abbiamo la certezza che ciò che sia stato dichiarato sia vero al 100%, tuttavia le azioni di Nvidia non l’hanno presa bene.
Il training di una intelligenza artificiale passa per diversi step, pre-training, fine-tuning supervisionato (SFT), apprendimento per rinforzo (RL) e variazioni o combinazioni. Per non dilungarsi in lectio magistralis, ci concentreremo sull’apprendimento per rinforzo, che ha giocato un ruolo fondamentale nei modelli DeepSeek (vedi approfondimenti).
Tradizionalmente, l’apprendimento per rinforzo si basa sul feedback umano di un esperto, che fornisce all’agente indicazioni dirette o indirette su quali azioni siano corrette o errate. Questo può avvenire attraverso la valutazione delle sue prestazioni o la definizione di comportamenti desiderati. Il feedback viene quindi utilizzato per addestrare un modello di ricompensa (il classico “biscottino” per i cani ubbidienti), che a sua volta guida l’apprendimento del modello linguistico principale tramite l’algoritmo PPO (Proximal Policy Optimization), aumentando la probabilità di adottare i comportamenti più efficaci. Sebbene questa supervisione umana sia fondamentale per indirizzare l’apprendimento dell’agente, comporta costi elevati e tempi lunghi, soprattutto quando il training si basa su un numero limitato di dati.
Per l’addestramento del modello R1, DeepSeek ha affiancato al metodo supervisionato da umano, una tecnica che possiamo definire più innovativa: l’affiancamento di un altro modello di intelligenza artificiale (il “valutatore”), addestrato a giudicare la qualità delle risposte del modello principale, fornendo un segnale di ricompensa che guida l’apprendimento.
DeepSeek ha sviluppato, quindi, un’altra versione del suo modello di intelligenza artificiale, R1 Zero, addestrato utilizzando esclusivamente il reinforcement learning (RL) senza alcun intervento umano, dimostrando che i modelli linguistici possono sviluppare capacità di ragionamento avanzate attraverso l’auto-evoluzione guidata da segnali di ricompensa, nonostante la manifestazione di problemi di leggibilità e mescolanze linguistiche.
L’azienda cinese si è, inoltre, specializzata nella distillazione di modelli IA, cioè il processo di trasferimento delle conoscenze di modelli di grandi dimensioni verso modelli più piccoli, con performance simili. Questa preparazione ha insospettito OpenAI, che ha avanzato l’ipotesi che DeepSeek abbia utilizzato per questo scopo alcuni loro modelli senza autorizzazione. Per il momento non si sa con certezza se questo fatto si sia verificato o meno.
Perché l’architettura pensata da DeepSeek è diversa?
I modelli più noti utilizzano un’architettura densa (oppure scelgono di non divulgare la reale architettura). In un’architettura densa, ogni neurone in un determinato strato è connesso a tutti i neuroni dello strato precedente e successivo. Questo significa che quando un input (per esempio, una parola o una frase) viene elaborato, tutti i parametri del modello vengono attivati e contribuiscono al calcolo dell’output. I modelli densi sono ideali per apprendere rappresentazioni generali dei dati in modo molto efficace, ma richiedono maggiori quantità di calcoli e sono computazionalmente più costosi.
DeepSeek, come altre aziende ma con un focus ancora maggiore sull’efficientamento, utilizza un’architettura MoE (Mixture of Experts). Questo approccio si basa su più reti più piccole, chiamate “Esperti“, ognuna specializzata in aspetti specifici dei dati o in determinati compiti. A coordinarle è una rete neurale denominata Gate (o Router), che analizza l’input e determina quali esperti attivare. Gli output generati da questi esperti vengono poi combinati per produrre il risultato finale.
Poiché solo un sottoinsieme di esperti viene attivato per ogni input, il costo computazionale è significativamente inferiore rispetto a una rete densa di dimensioni comparabili e questo tipo di architetture possono essere scalate a dimensioni molto grandi aggiungendo più esperti, senza aumentare in modo quadratico il costo computazionale (a differenza dei modelli densi). Non è difficile intuire che la qualità del gate e la sua capacità di scegliere in modo ponderato gli esperti sia il vero ago della bilancia, tra accuratezza e caos.
L’ultima carta vincente è l’open source?
In un mondo come quello dell’intelligenza artificiale generativa, dominata dai segreti aziendali volti a massimizzare i primati, alcune aziende scelgono l’approccio open source. Nel caso di DeepSeek, questa manovra risulta ancora più pericolosa per la Silicon Valley, perché rappresenta la miglior nave con cui potesse sperare di navigare oltre oceano. Farlo con un modello “pensante” come R1, efficiente e performante, rappresenta un ulteriore biglietto d’oro.
DeepSeek R1 e le sue limitazioni
DeepSeek ha presentato al mondo intero il suo modello all’interno di una chat simile a quella di ChatGPT, sollevando preoccupazioni sulla privacy, dal momento che i server dell’azienda risiedono in Cina e il trattamento dei dati non è trasparente, tanto che anche il Garante della Privacy Italiana ha preso provvedimenti. Perplexity e altre aziende hanno colto l’occasione al volo e utilizzano il modello su server americani ed europei risolvendo il problema e (pare) aggirando la criticata censura implementata nel cloud cinese (qualcuno ha parlato di piazze?).
Inoltre, pare che il modello sia un po’ più instabile con specifici parametri, tanto che DeepSeek consiglia range molto controllati in termini di temperatura e prompt specifici per “incoraggiare” il modello a ragionare e rispondere in modo coerente.
E adesso?
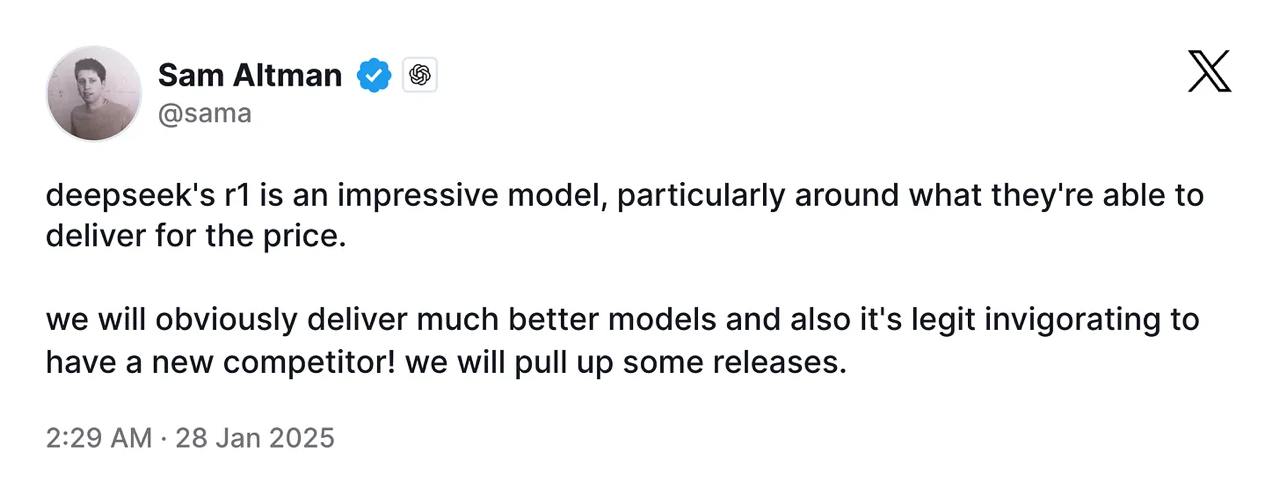
I colossi del settore stanno già rispondendo alla sfida, e possiamo aspettarci grandi sviluppi anche dai modelli open source e community-driven. Un esempio? Qwen di Alibaba, che si fa notare con la sua nuova versione Max. Se non fosse già chiaro, la battaglia sui Large-Language Models è tutt’altro che finita. Anzi, probabilmente non finirà mai.
La nostra divisione Synesthesia AI realizza soluzioni digitali mettendo in campo competenze, servizi e tecnologie di ultima generazione come l’Intelligenza Artificiale generativa, start-up acceleration, machine learning, R&D as a service, industria 4.0/industria 5.0. Synesthesia AI si impegna a fornire soluzioni di alta qualità per problemi complessi. Il nostro team di esperti crea algoritmi e modelli avanzati che consentono di affrontare sfide complesse in diversi settori. Se sei interessato/a a strumenti AI nel settore museale, contattaci. Il nostro team AI potrà creare insieme a te la soluzione più adatta ed efficiente per i tuoi progetti.